Les ordinateurs quantiques apprennent à corriger leurs propres erreurs
La prochaine étape utile ne consiste pas seulement à ajouter des qubits. Il faut protéger une information quantique fragile assez longtemps pour accomplir un vrai calcul.
Pendant des années, les annonces sur les ordinateurs quantiques se résumaient facilement à un nombre : combien de qubits possède la nouvelle puce ? Ce nombre compte encore, mais il dit étonnamment peu, à lui seul, sur ce qu’une machine peut calculer.
Un qubit est extrêmement sensible. Chaleur, vibrations, champs électromagnétiques parasites et impulsions de commande imparfaites peuvent le perturber. Même près du zéro absolu, les opérations introduisent des erreurs. Ajouter des qubits sans maîtriser ces erreurs peut simplement créer une plus grande source de résultats peu fiables.
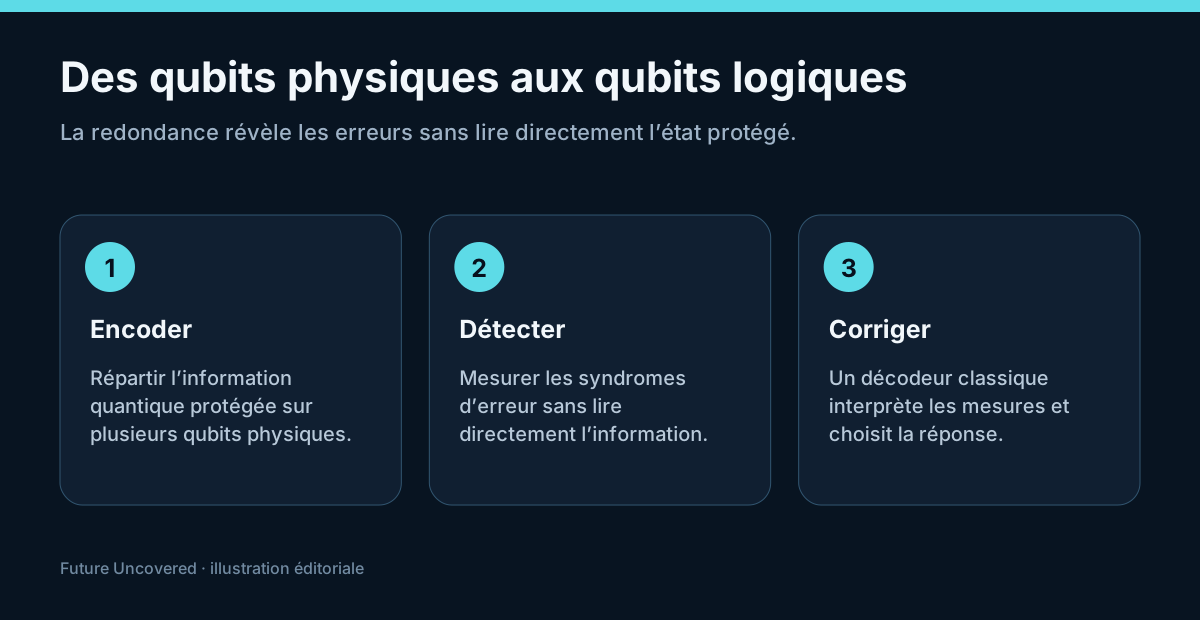
C’est pourquoi l’attention passe des qubits physiques aux qubits logiques. Un qubit logique est une information protégée par un code correcteur et répartie sur plusieurs qubits physiques. L’objectif n’est pas de rendre chaque composant parfait, mais de rendre l’information encodée plus fiable qu’un composant isolé.
Les erreurs quantiques sont différentes
La redondance est familière en informatique classique. On conserve plusieurs copies d’un bit, on les compare, puis on retient la valeur majoritaire si l’une change. L’information quantique complique cela. Un qubit peut être dans une superposition d’états, et une mesure directe modifie normalement son état. Le théorème de non-clonage interdit aussi une copie parfaite arbitraire comme simple sauvegarde.
La correction quantique recherche donc la signature d’une erreur sans lire directement l’information protégée. Des qubits supplémentaires sont disposés de façon que certaines mesures, appelées mesures de syndrome, indiquent si un problème s’est probablement produit et où. Un décodeur classique interprète ces résultats et détermine la réponse du calcul.
Une méthode très étudiée est le code de surface : les qubits forment une grille et l’on vérifie leurs relations locales. D’autres codes choisissent des organisations et des compromis différents. Il n’existe pas de recette universelle. Le nombre de qubits physiques nécessaire à un qubit logique utile dépend de la qualité du matériel, du code et du calcul envisagé.
Le seuil est le test décisif
La correction doit remplir une condition exigeante. L’ajout de qubits physiques et l’agrandissement du code doivent réduire le taux d’erreurs logiques. Si les composants supplémentaires introduisent des erreurs plus vite que le code ne les maîtrise, agrandir le système aggrave le résultat.
Cette limite est le seuil de correction d’erreurs. En dessous, un code plus grand devrait mieux supprimer les erreurs logiques. Dans un article de Nature publié en 2024, Google Quantum AI a présenté des mémoires à code de surface sous ce seuil sur le processeur Willow : lorsque la distance du code augmentait, l’information encodée était conservée plus fidèlement. C’était un résultat expérimental important, mais pas un ordinateur quantique universel tolérant aux fautes.
La distinction compte. Une mémoire protégée, une porte logique et un algorithme complet sont des réalisations différentes. Une machine utile doit préparer des états logiques, exécuter de nombreuses opérations, relier des modules si nécessaire, décoder assez vite et fournir un résultat avant que le bruit restant ne le submerge.
Pourquoi 2026 révèle la direction prise
Les feuilles de route décrivent de plus en plus la performance autrement que par le nombre brut de qubits. Celle d’IBM pour 2026 prévoit par exemple des circuits plus profonds, le décodage en temps réel et un module associant traitement logique et mémoire quantique. En juillet 2026, IBM a aussi proposé trois mesures pratiques du matériel : les qubits programmables, les opérations sur les qubits et le nombre maximal de circuits par seconde.
Ce sont des objectifs d’entreprise et des indicateurs définis par l’entreprise, pas une preuve indépendante d’avantage quantique. Une feuille de route peut changer. Elle montre néanmoins le goulet d’étranglement identifié par les ingénieurs : qualité, connectivité, vitesse et gestion des erreurs doivent progresser ensemble.
Ce mouvement se retrouve dans tout le domaine. Les équipes développent de meilleurs qubits physiques, un câblage plus dense, une électronique plus rapide, des liaisons modulaires et des codes plus efficaces. Un progrès sur une couche peut soulager les autres.
Ce qu’indique un qubit logique
Compter les qubits logiques est plus instructif que compter les composants, mais ce n’est toujours pas un score complet. Deux qubits logiques peuvent avoir des taux d’erreurs différents. Conserver un état ne signifie pas encore exécuter une longue suite de portes très fidèles. Une bonne performance sur un test ne se transpose pas automatiquement à la chimie, à l’optimisation ou à la cryptographie.
Voici des questions utiles :
- Combien d’opérations le qubit logique peut-il supporter ?
- La fiabilité augmente-t-elle avec la taille du code ?
- Quelles portes ont été démontrées, avec quel taux d’erreurs ?
- Le résultat inclut-il le temps et le matériel nécessaires au décodage ?
- Une tâche pratique a-t-elle montré un avantage vérifié sur la meilleure méthode classique ?
Ces questions compliquent les annonces spectaculaires, mais rendent les progrès réels plus faciles à reconnaître.
Le but n’est pas un qubit parfaitement silencieux. C’est un système capable de rester fiable alors que chaque élément physique est légèrement imparfait.
La cryptographie actuelle sera-t-elle cassée ?
De grands ordinateurs quantiques tolérants aux fautes pourraient menacer des systèmes à clé publique répandus, en exécutant notamment l’algorithme de Shor à une échelle suffisante. Les machines expérimentales actuelles ne le peuvent pas. Les estimations varient selon la qualité du matériel, l’efficacité du code et la longueur de la clé cryptographique.
Les organismes de sécurité n’attendent pas la machine définitive. Le NIST a normalisé des algorithmes postquantiques qui fonctionnent sur des ordinateurs ordinaires et visent à résister aux attaques classiques et quantiques. La migration prend des années : la cryptographie est intégrée aux logiciels, aux appareils et aux données conservées longtemps. Se préparer relève de la gestion des risques, pas de la preuve qu’une machine capable de casser ces protections existe déjà.
Où le calcul quantique utile pourrait commencer
Un ordinateur quantique n’est pas un ordinateur portable plus rapide. C’est une machine spécialisée qui pourrait aider pour certaines simulations, questions de matériaux et tâches mathématiques. Pour beaucoup d’usages, les ordinateurs classiques resteront moins chers, plus rapides et plus simples.
Les premiers systèmes utiles pourraient travailler avec des calculateurs classiques puissants. Les processeurs classiques prépareront les tâches, commanderont le matériel, décoderont les erreurs et analyseront les résultats. Le processeur quantique n’interviendra que là où sa structure apporte un véritable avantage.
La correction est ainsi le pont entre une démonstration en laboratoire et un service de calcul fiable. Sans elle, un long algorithme accumule du bruit. Avec elle, on peut en principe prolonger le calcul en ajoutant suffisamment de matériel fiable et de capacité de décodage.
Le travail classique caché
La correction montre aussi qu’un ordinateur quantique n’est pas une boîte isolée. Les mesures de syndrome peuvent arriver en continu. L’électronique classique doit les recueillir, un décodeur doit déduire les erreurs probables, et la commande doit suivre le rythme du matériel quantique. Si cette boucle est trop lente, l’état protégé peut disparaître avant la réaction.
Le problème relie physique et informatique conventionnelle. De meilleurs algorithmes réduisent le décodage ; des puces plus rapides raccourcissent la boucle. Des composants cryogéniques peuvent rapprocher certaines commandes des qubits, tandis que d’autres tâches restent hors du réfrigérateur. Une architecture crédible doit donc prévoir alimentation, refroidissement, câblage et calcul classique, en plus du processeur quantique.
Cela change également l’économie du système. Un calcul utile doit justifier tout son environnement technique, pas seulement ses qubits physiques. C’est pourquoi les chercheurs comparent des tâches complètes au lieu de remplacer la mesure de performance par un nombre de qubits.
Mieux lire la prochaine annonce
À la présentation de la prochaine puce, regardez au-delà du plus grand nombre du titre. Quels qubits compte-t-on ? Comment les erreurs ont-elles été mesurées ? L’agrandissement a-t-il amélioré les résultats ? S’agit-il d’une expérience publiée, d’un programme d’entreprise ou d’une projection ?
La correction quantique ne signifie pas que le travail est terminé. Elle montre que des éléments nécessaires à la maîtrise de cette fragilité fonctionnent déjà. La découverte n’est pas que les systèmes quantiques font des erreurs, mais qu’une redondance bien conçue peut permettre à l’information utile d’y survivre.
Sources et lectures complémentaires
- Google Quantum AI and collaborators — Quantum error correction below the surface code threshold (Nature, 2024)
- Google — Meet Willow, our state-of-the-art quantum chip
- IBM — Quantum Roadmap
- IBM — How to measure the performance of a quantum computer (16 July 2026)
- NIST — Post-Quantum Cryptography
- NIST NCCoE — Migration to Post-Quantum Cryptography