Quantencomputer lernen, ihre eigenen Fehler zu korrigieren
Der nächste wichtige Schritt ist nicht einfach eine Maschine mit mehr Qubits. Sie muss empfindliche Quanteninformation lange genug schützen, um nützliche Arbeit zu leisten.
Jahrelang ließen sich Meldungen über Quantencomputer leicht auf eine Zahl reduzieren: Wie viele Qubits hat der neue Chip? Diese Zahl bleibt wichtig, sagt allein aber erstaunlich wenig darüber, was eine Maschine berechnen kann.
Ein Qubit ist außerordentlich empfindlich. Wärme, Vibrationen, unerwünschte elektromagnetische Felder und ungenaue Steuerimpulse können seinen Zustand stören. Selbst nahe dem absoluten Nullpunkt verursachen Operationen Fehler. Werden mehr Qubits eingebaut, ohne diese Fehler zu beherrschen, liefert eine größere Maschine womöglich nur mehr unzuverlässige Ergebnisse.
Deshalb richtet sich der Blick zunehmend von physischen Qubits auf logische Qubits. Ein logisches Qubit ist Information, die durch einen Fehlerkorrekturcode geschützt und über viele physische Qubits verteilt wird. Nicht jedes Bauteil muss perfekt werden. Die codierte Information soll zuverlässiger sein als ein einzelnes Bauteil.
Quantenfehler sind anders
Bei normalen Computern ist Redundanz vertraut. Man speichert mehrere Kopien eines Bits, vergleicht sie und übernimmt bei einer Abweichung den Mehrheitswert. Quanteninformation macht das schwieriger. Ein Qubit kann in einer Überlagerung von Zuständen sein; eine direkte Messung verändert normalerweise seinen Zustand. Das No-Cloning-Theorem verhindert außerdem eine beliebige perfekte Kopie als einfache Sicherung.
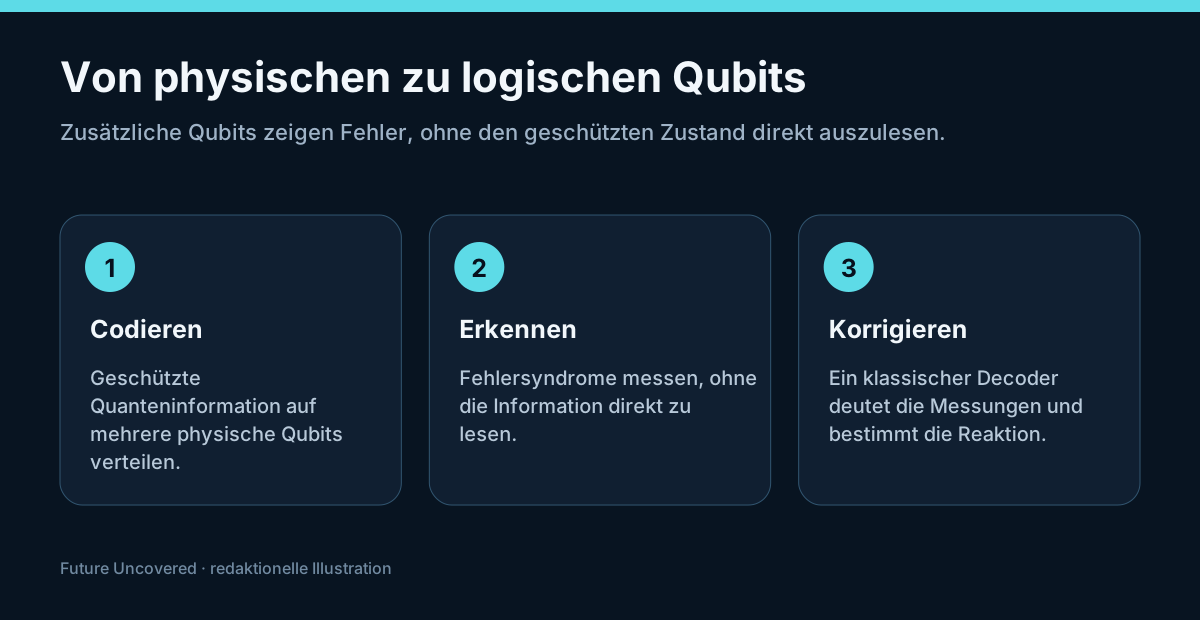
Quantenfehlerkorrektur sucht daher nach dem Muster eines Fehlers, ohne die geschützte Information direkt auszulesen. Zusätzliche Qubits werden so angeordnet, dass ausgewählte Messungen, sogenannte Syndrommessungen, auf wahrscheinliche Fehler und deren Ort hinweisen. Ein klassischer Decoder wertet die Ergebnisse aus und bestimmt die Reaktion der Berechnung.
Ein häufig untersuchter Ansatz ist der Oberflächencode. Er ordnet Qubits in einem Gitter an und prüft örtliche Beziehungen. Andere Codes nutzen andere Anordnungen und Kompromisse. Es gibt kein Universalrezept. Wie viele physische Qubits für ein nützliches logisches Qubit nötig sind, hängt von Hardwarequalität, Code und gewünschter Berechnung ab.
Die entscheidende Prüfung ist die Fehlerschwelle
Fehlerkorrektur muss eine anspruchsvolle Bedingung erfüllen. Mehr physische Qubits und ein größerer Code müssen die logische Fehlerrate senken. Bringen die zusätzlichen Komponenten schneller neue Fehler ein, als der Code sie auffangen kann, verschlechtert die Vergrößerung das Ergebnis.
Diese Grenze heißt Fehlerkorrekturschwelle. Unterhalb davon sollte ein größerer Code logische Fehler stärker unterdrücken. In einer 2024 in Nature veröffentlichten Arbeit berichtete Google Quantum AI über Oberflächencode-Speicher unterhalb der Schwelle auf dem Willow-Prozessor: Mit größerem Codeabstand blieb die codierte Information zuverlässiger erhalten. Das war ein wichtiges Experiment, aber noch kein universeller fehlertoleranter Quantencomputer.
Die Unterscheidung zählt. Ein geschützter Quantenspeicher, ein logisches Gatter und ein vollständiger Algorithmus sind verschiedene Leistungen. Eine brauchbare Maschine muss logische Zustände vorbereiten, viele Operationen ausführen, gegebenenfalls Module verbinden, Fehler schnell genug decodieren und ein Ergebnis liefern, bevor das verbleibende Rauschen überhandnimmt.
Warum 2026 die Richtung erkennen lässt
Aktuelle Entwicklungspläne nennen zunehmend mehr als reine Qubit-Zahlen. IBMs Roadmap für 2026 enthält beispielsweise Ziele für tiefere Schaltungen, Echtzeit-Decodierung und ein Prozessormodul, das logische Verarbeitung mit Quantenspeicher verbindet. Im Juli 2026 schlug IBM zudem drei praktische Hardwaremaße vor: programmierbare Qubits, Qubit-Operationen und maximal ausgeführte Schaltungen pro Sekunde.
Das sind Unternehmensziele und vom Unternehmen definierte Kennzahlen, kein unabhängiger Nachweis eines Quantenvorteils. Roadmaps können sich ändern. Sie zeigen aber, wo Ingenieure den Engpass sehen: Qualität, Verbindungen, Geschwindigkeit und Fehlerbehandlung müssen gemeinsam besser werden.
Derselbe Wandel ist im ganzen Forschungsfeld sichtbar. Teams entwickeln bessere physische Qubits, dichtere Verkabelung, schnellere Steuerelektronik, Verbindungen zwischen Modulen und effizientere Codes. Fortschritt auf einer Ebene kann die anderen entlasten.
Was ein logisches Qubit aussagt
Die Zahl logischer Qubits ist aussagekräftiger als die bloße Bauteilzahl, bleibt aber unvollständig. Zwei logische Qubits können unterschiedliche Fehlerraten haben. Eine Maschine, die einen Zustand speichert, beherrscht nicht automatisch lange Folgen präziser Gatter. Ein beeindruckender Benchmark muss sich nicht auf Chemie, Optimierung oder Kryptografie übertragen lassen.
Hilfreiche Fragen sind:
- Wie viele Operationen übersteht das logische Qubit?
- Steigt die Zuverlässigkeit mit der Größe des Codes?
- Welche Gatter wurden mit welcher Fehlerrate gezeigt?
- Sind Zeit und Hardware für die Fehlerdecodierung berücksichtigt?
- Gab es eine praktische Aufgabe mit nachgewiesenem Vorteil gegenüber der besten klassischen Methode?
Diese Fragen machen griffige Behauptungen komplizierter, echten Fortschritt aber leichter erkennbar.
Das Ziel ist kein vollkommen störungsfreies Qubit, sondern ein System, das zuverlässig bleibt, obwohl jedes physische Teil ein wenig unvollkommen ist.
Wird damit heutige Verschlüsselung geknackt?
Große, fehlertolerante Quantencomputer könnten verbreitete Public-Key-Verfahren bedrohen, indem sie Algorithmen wie Shors Algorithmus in ausreichender Größe ausführen. Heutige Versuchsmaschinen können das nicht. Schätzungen unterscheiden sich, weil Hardwarequalität, Code-Effizienz und Länge des kryptografischen Schlüssels entscheidend sind.
Sicherheitsinstitutionen warten nicht auf die fertige Maschine. NIST hat Post-Quanten-Algorithmen standardisiert, die auf gewöhnlichen Computern laufen und klassischen wie quantenbasierten Angriffen widerstehen sollen. Die Umstellung dauert Jahre, weil Kryptografie in Software, Geräten und langfristig gespeicherten Daten steckt. Frühe Vorbereitung ist Risikovorsorge, kein Beleg für einen bereits vorhandenen Codeknacker.
Wo nützliche Quantenberechnung beginnen könnte
Quantencomputer sind keine schnelleren Laptops. Sie sind Spezialmaschinen, die bei bestimmten Simulationen, Materialfragen und mathematischen Aufgaben helfen könnten. Für viele Arbeiten bleiben klassische Computer günstiger, schneller und einfacher.
Die ersten nützlichen Systeme könnten mit leistungsfähigen klassischen Rechnern zusammenarbeiten. Klassische Prozessoren bereiten Aufgaben vor, steuern die Hardware, decodieren Fehler und analysieren Ergebnisse. Quantenprozessoren übernehmen nur die Schritte, bei denen ihre Struktur einen echten Vorteil bietet.
Fehlerkorrektur ist damit die Brücke zwischen einem Laborversuch und einem verlässlichen Rechendienst. Ohne sie sammelt ein langer Algorithmus Rauschen an. Mit ihr lässt sich eine Berechnung grundsätzlich verlängern, wenn ausreichend zuverlässige Hardware und Decodierleistung hinzukommen.
Die verborgene klassische Rechenarbeit
Fehlerkorrektur erklärt auch, weshalb ein Quantencomputer nicht als abgeschlossener Kasten allein arbeitet. Syndrommessungen können fortlaufend eintreffen. Klassische Elektronik sammelt sie, ein Decoder ermittelt das wahrscheinlichste Fehlermuster, und die Steuerung muss mit der Quantenhardware Schritt halten. Ist diese Schleife zu langsam, kann der geschützte Zustand vor der Reaktion verloren gehen.
Das verbindet Physik mit herkömmlicher Informatik. Bessere Algorithmen verringern die Decodierarbeit, schnellere Chips verkürzen die Rückkopplung. Kryogene Bauteile können einen Teil der Steuerung näher an die Qubits bringen; andere Aufgaben bleiben außerhalb des Kühlsystems. Ein glaubwürdiger Entwurf braucht deshalb Stromversorgung, Kühlung, Kabel und klassische Verarbeitung ebenso wie einen Quantenprozessor.
Das verändert auch die Kosten. Eine nützliche Berechnung muss den Aufwand des gesamten Systems rechtfertigen, nicht nur die Zahl physischer Qubits. Deshalb vergleichen Forschende vollständige Arbeitsabläufe, statt Qubit-Zahlen mit Leistung gleichzusetzen.
Die nächste Ankündigung besser einordnen
Wenn der nächste Quantenchip vorgestellt wird, schauen Sie über die größte Zahl in der Überschrift hinaus. Welche Qubits werden gezählt? Wie wurden Fehler gemessen? Wurde die Leistung beim Vergrößern besser? Handelt es sich um ein veröffentlichtes Experiment, einen Unternehmensplan oder eine Prognose?
Quantenfehlerkorrektur bedeutet nicht, dass die Entwicklung abgeschlossen ist. Ingenieure zeigen Bausteine, mit denen sich die Empfindlichkeit beherrschen lässt. Die Entdeckung ist nicht, dass Quantensysteme Fehler machen. Sie besteht darin, dass sorgfältig geplante Redundanz nützliche Information davor schützen kann.
Quellen und weiterführende Informationen
- Google Quantum AI and collaborators — Quantum error correction below the surface code threshold (Nature, 2024)
- Google — Meet Willow, our state-of-the-art quantum chip
- IBM — Quantum Roadmap
- IBM — How to measure the performance of a quantum computer (16 July 2026)
- NIST — Post-Quantum Cryptography
- NIST NCCoE — Migration to Post-Quantum Cryptography