Komputery kwantowe uczą się korygować własne błędy
Kolejny ważny krok to nie tylko więcej kubitów. Potrzebna jest maszyna, która ochroni delikatną informację kwantową na tyle długo, by wykonać użyteczną pracę.
Przez lata informacje o komputerach kwantowych łatwo było sprowadzić do jednej liczby: ile kubitów ma nowy układ? Ta liczba nadal ma znaczenie, ale sama mówi zaskakująco mało o tym, co urządzenie potrafi obliczyć.
Kubit jest niezwykle wrażliwy. Ciepło, drgania, przypadkowe pola elektromagnetyczne i niedokładne impulsy sterujące mogą zakłócić jego stan. Błędy pojawiają się podczas operacji nawet wtedy, gdy sprzęt utrzymuje się blisko zera bezwzględnego. Jeśli doda się więcej kubitów bez opanowania błędów, większa maszyna może po prostu produkować więcej niewiarygodnych wyników.
Dlatego uwaga przesuwa się z kubitów fizycznych na kubity logiczne. Kubit logiczny to informacja zabezpieczona kodem korekcji błędów i rozłożona na wiele kubitów fizycznych. Celem nie jest uzyskanie idealnych części. Chodzi o to, by zapisana w ten sposób informacja była bardziej niezawodna niż pojedynczy element.
Błędy kwantowe są inne
W zwykłym komputerze dodatkowe kopie to znany pomysł. Można zapisać bit kilka razy, porównać kopie i przyjąć wartość większości, gdy jedna się zmieni. Z informacją kwantową jest trudniej. Kubit może znajdować się w superpozycji stanów, a bezpośredni pomiar zwykle zmienia jego stan. Zasada zakazu klonowania uniemożliwia też wykonanie dowolnej, idealnej kopii jako prostej kopii zapasowej.
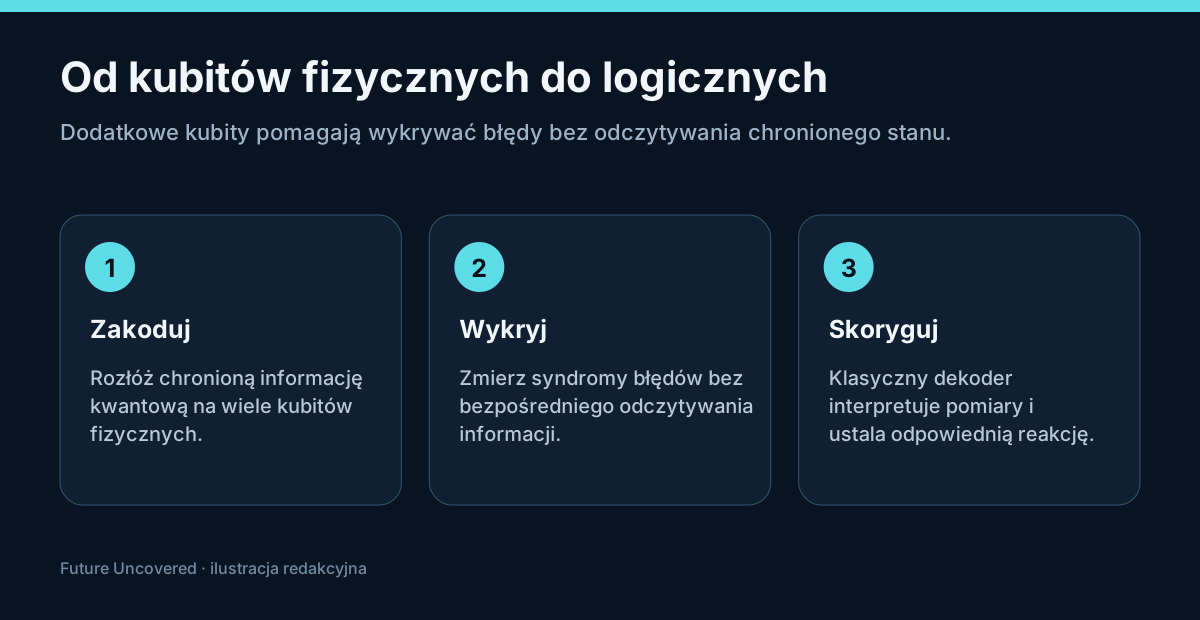
Korekcja błędów kwantowych szuka więc śladów błędu bez bezpośredniego odczytywania chronionej informacji. Dodatkowe kubity rozmieszcza się tak, aby odpowiednio dobrane pomiary — zwane pomiarami syndromu — wskazywały, czy coś prawdopodobnie poszło źle i gdzie. Klasyczny dekoder interpretuje wyniki i ustala, jak obliczenie powinno zareagować.
Jednym z szeroko badanych rozwiązań jest kod powierzchniowy: kubity tworzą siatkę, a pomiary sprawdzają lokalne zależności między nimi. Inne kody stosują odmienne układy i kompromisy. Nie ma jednej recepty. Liczba kubitów fizycznych potrzebnych do utworzenia użytecznego kubitu logicznego zależy od jakości sprzętu, konstrukcji kodu i planowanego obliczenia.
Najważniejszy test: próg korekcji
Korekcja musi spełnić wymagający warunek. Dodawanie kubitów fizycznych i powiększanie kodu powinno zmniejszać częstość błędów logicznych. Jeżeli nowe części wprowadzają błędy szybciej, niż kod potrafi sobie z nimi radzić, rozbudowa pogarsza wynik.
Badacze nazywają tę granicę progiem korekcji błędów. Poniżej niego większy kod powinien skuteczniej ograniczać błędy logiczne. W pracy opublikowanej w Nature w 2024 roku Google Quantum AI opisało pamięci z kodem powierzchniowym działające poniżej tego progu na procesorze Willow: wraz ze wzrostem odległości kodu zakodowana informacja była przechowywana bardziej niezawodnie. To ważny wynik eksperymentalny, ale nie uniwersalny komputer kwantowy odporny na błędy.
To rozróżnienie ma znaczenie. Chroniona pamięć kwantowa, bramka logiczna i pełny algorytm to różne osiągnięcia. Użyteczna maszyna musi przygotowywać stany logiczne, wykonywać wiele operacji, w razie potrzeby łączyć moduły, odpowiednio szybko dekodować błędy i dostarczyć wynik, zanim pozostały szum go zniszczy.
Dlaczego rok 2026 pokazuje kierunek zmian?
Plany rozwoju coraz częściej opisują wydajność inaczej niż samą liczbą kubitów. Plan IBM na 2026 rok wymienia na przykład dłuższe obwody, dekodowanie w czasie rzeczywistym oraz moduł procesora łączący przetwarzanie logiczne z pamięcią kwantową. W lipcu 2026 roku firma zaproponowała też trzy praktyczne miary sprzętowe: programowalne kubity, operacje na kubitach i maksymalną liczbę obwodów na sekundę.
Są to cele firmy i miary przez nią zdefiniowane, a nie niezależny dowód przewagi kwantowej. Plany mogą się zmieniać. Pokazują jednak, gdzie inżynierowie widzą dziś wąskie gardło: jakość, połączenia, szybkość i zarządzanie błędami muszą poprawiać się razem.
Podobną zmianę widać w całej dziedzinie. Zespoły pracują nad lepszymi kubitami fizycznymi, gęstszym okablowaniem, szybszą elektroniką sterującą, połączeniami między modułami i wydajniejszymi kodami. Postęp w jednej warstwie może zmniejszyć obciążenie pozostałych.
Co mówi nam kubit logiczny?
Liczba kubitów logicznych znaczy więcej niż liczba samych elementów, ale nadal nie jest pełną oceną. Dwa kubity logiczne mogą mieć różną częstość błędów. Maszyna przechowująca stan nie musi jeszcze wykonywać długich ciągów bardzo dokładnych bramek. Dobry wynik jednego testu nie musi przekładać się na chemię, optymalizację czy kryptografię.
Warto zadać konkretne pytania:
- Ile operacji może przetrwać kubit logiczny?
- Czy niezawodność rośnie wraz z rozmiarem kodu?
- Jakie bramki pokazano i z jaką częstością błędów?
- Czy wynik uwzględnia czas i sprzęt potrzebne do dekodowania błędów?
- Czy wykonano praktyczne zadanie z potwierdzoną przewagą nad najlepszą metodą klasyczną?
Te pytania komplikują efektowne nagłówki, ale ułatwiają rozpoznanie rzeczywistego postępu.
Celem nie jest idealnie spokojny kubit. Jest nim system, który pozostaje niezawodny, choć każda fizyczna część jest trochę niedoskonała.
Czy to złamie dzisiejsze szyfrowanie?
Duże komputery kwantowe odporne na błędy mogłyby zagrozić powszechnym systemom klucza publicznego, uruchamiając na odpowiednią skalę algorytmy takie jak algorytm Shora. Dzisiejsze urządzenia eksperymentalne tego nie potrafią. Szacunki potrzebnego sprzętu różnią się, bo zależą od jego jakości, sprawności kodu i długości klucza kryptograficznego.
Instytucje zajmujące się bezpieczeństwem nie czekają na gotową maszynę. NIST ustanowił standardy algorytmów postkwantowych, które działają na zwykłych komputerach i mają opierać się atakom klasycznym oraz kwantowym. Przejście zajmuje lata, ponieważ kryptografia jest częścią oprogramowania, urządzeń i długo przechowywanych danych. Przygotowania to zarządzanie ryzykiem, a nie dowód, że komputer łamiący te zabezpieczenia już powstał.
Gdzie może zacząć się praktyczne zastosowanie?
Komputer kwantowy nie jest szybszą wersją laptopa. To wyspecjalizowana maszyna, która może pomóc w wybranych symulacjach, badaniach materiałów i zadaniach matematycznych. W wielu zastosowaniach komputery klasyczne pozostaną tańsze, szybsze i prostsze.
Pierwsze użyteczne systemy mogą współpracować z wydajnymi komputerami klasycznymi. Klasyczne procesory przygotują zadania, pokierują sprzętem, odkodują błędy i przeanalizują wyniki. Procesor kwantowy wykona tylko te etapy, w których jego konstrukcja daje rzeczywistą przewagę.
Korekcja błędów staje się więc pomostem między pokazem laboratoryjnym a niezawodną usługą obliczeniową. Bez niej długi algorytm zbiera kolejne zakłócenia. Z nią — przynajmniej w zasadzie — można wydłużać obliczenie, dodając odpowiednio dużo niezawodnego sprzętu i możliwości dekodowania.
Ukryta praca klasycznych komputerów
Korekcja wyjaśnia też, dlaczego komputer kwantowy nie jest samotnie działającą skrzynką. Wyniki pomiarów syndromu mogą napływać bez przerwy. Elektronika klasyczna musi je zbierać, dekoder rozpoznawać najbardziej prawdopodobny układ błędów, a sterowanie nadążać za sprzętem kwantowym. Jeśli pętla działa zbyt wolno, chroniony stan może zniknąć przed reakcją maszyny.
To problem łączący fizykę z tradycyjną informatyką. Lepsze algorytmy mogą ograniczyć pracę dekodera, szybsze układy skrócić czas reakcji. Elektronika kriogeniczna może przenieść część sterowania bliżej kubitów, podczas gdy inne zadania pozostaną poza chłodziarką. Wiarygodny projekt musi więc uwzględniać zasilanie, chłodzenie, kable i klasyczne przetwarzanie, obok samego procesora kwantowego.
Zmienia to również koszty. Użyteczne obliczenie musi uzasadnić nakłady na całe zaplecze, a nie tylko na kubity fizyczne. Dlatego badacze porównują pełne zadania, zamiast traktować liczbę kubitów jako zamiennik wydajności.
Jak czytać następne ogłoszenie?
Kiedy pojawi się kolejny układ kwantowy, spójrz poza największą liczbę w nagłówku. Sprawdź, jaki rodzaj kubitów policzono, jak mierzono błędy i czy rozbudowa poprawiła działanie. Ustal, czy oglądasz opublikowany eksperyment, plan firmy czy prognozę.
Korekcja błędów nie oznacza, że prace dobiegły końca. Pokazuje, że inżynierowie demonstrują elementy potrzebne do opanowania kwantowej kruchości. Odkryciem nie jest to, że systemy kwantowe popełniają błędy. Jest nim możliwość ochrony użytecznej informacji przez odpowiednio zaprojektowaną nadmiarowość.
Źródła i dalsza lektura
- Google Quantum AI and collaborators — Quantum error correction below the surface code threshold (Nature, 2024)
- Google — Meet Willow, our state-of-the-art quantum chip
- IBM — Quantum Roadmap
- IBM — How to measure the performance of a quantum computer (16 July 2026)
- NIST — Post-Quantum Cryptography
- NIST NCCoE — Migration to Post-Quantum Cryptography